Современный лингвист работает не только с текстами. Он может измерять скорость реакции человека на слово в миллисекундах, фиксировать движения глаз во время чтения, создавать корпуса из сотен часов звучащей речи, анализировать большие массивы текстов и проверять гипотезы с помощью методов обработки естественного языка и машинного обучения. Именно такой междисциплинарный подход развивает команда Томского государственного университета под руководством профессора Зои Резановой.
В проекте, поддержанном Российским научным фондом, ученые исследуют, как при понимании родного и второго языков взаимодействуют два типа опыта — перцептивный, связанный с нашими ощущениями и физическим взаимодействием с миром, и языковой, который накапливается благодаря словам и контекстам. Сопоставляя экспериментальные данные с компьютерными моделями, исследователи рассчитывают приблизиться к пониманию того, как формируется и используется значение слова.
В интервью Зоя Резанова рассказала о собственном научном пути, связи языка и сенсорного опыта, исследованиях в области компьютерной лингвистики и промежуточных результатах работы, поддержанной грантом Фонда. Материал опубликован в новом выпуске журнала «Открывай с РНФ» (№ 35).
// Ваш научный путь начинался с классической филологии, а сегодня вы работаете на пересечении когнитивной и компьютерной лингвистики, психолингвистики и анализа данных. Как произошел этот переход?
Действительно, моя научная траектория прошла путь от классической лингвистики ко все большей междисциплинарности. Кандидатская диссертация была посвящена словообразованию, а в докторской меня уже интересовала функциональная сторона языка: не только какие единицы существуют в языковой системе, но и почему человек выбирает их определенным образом, какие мыслительные механизмы стоят за тем, что мы наблюдаем в тексте.
В 2000-е наступили, как я их называю, «когнитивные времена» в российском филологическом сообществе. Нас заинтересовало, как язык связан с сознанием и мышлением, как человек категоризирует окружающий мир. Например, мы много занимались концептуальной метафорой. Метафора важна не только как художественный прием: то, что невозможно непосредственно увидеть или потрогать, мы часто осмысляем через знакомый физический опыт. Когда говорим «меня переполняют чувства», это абстрактное эмоциональное состояние описывается через вполне понятный телесный образ.
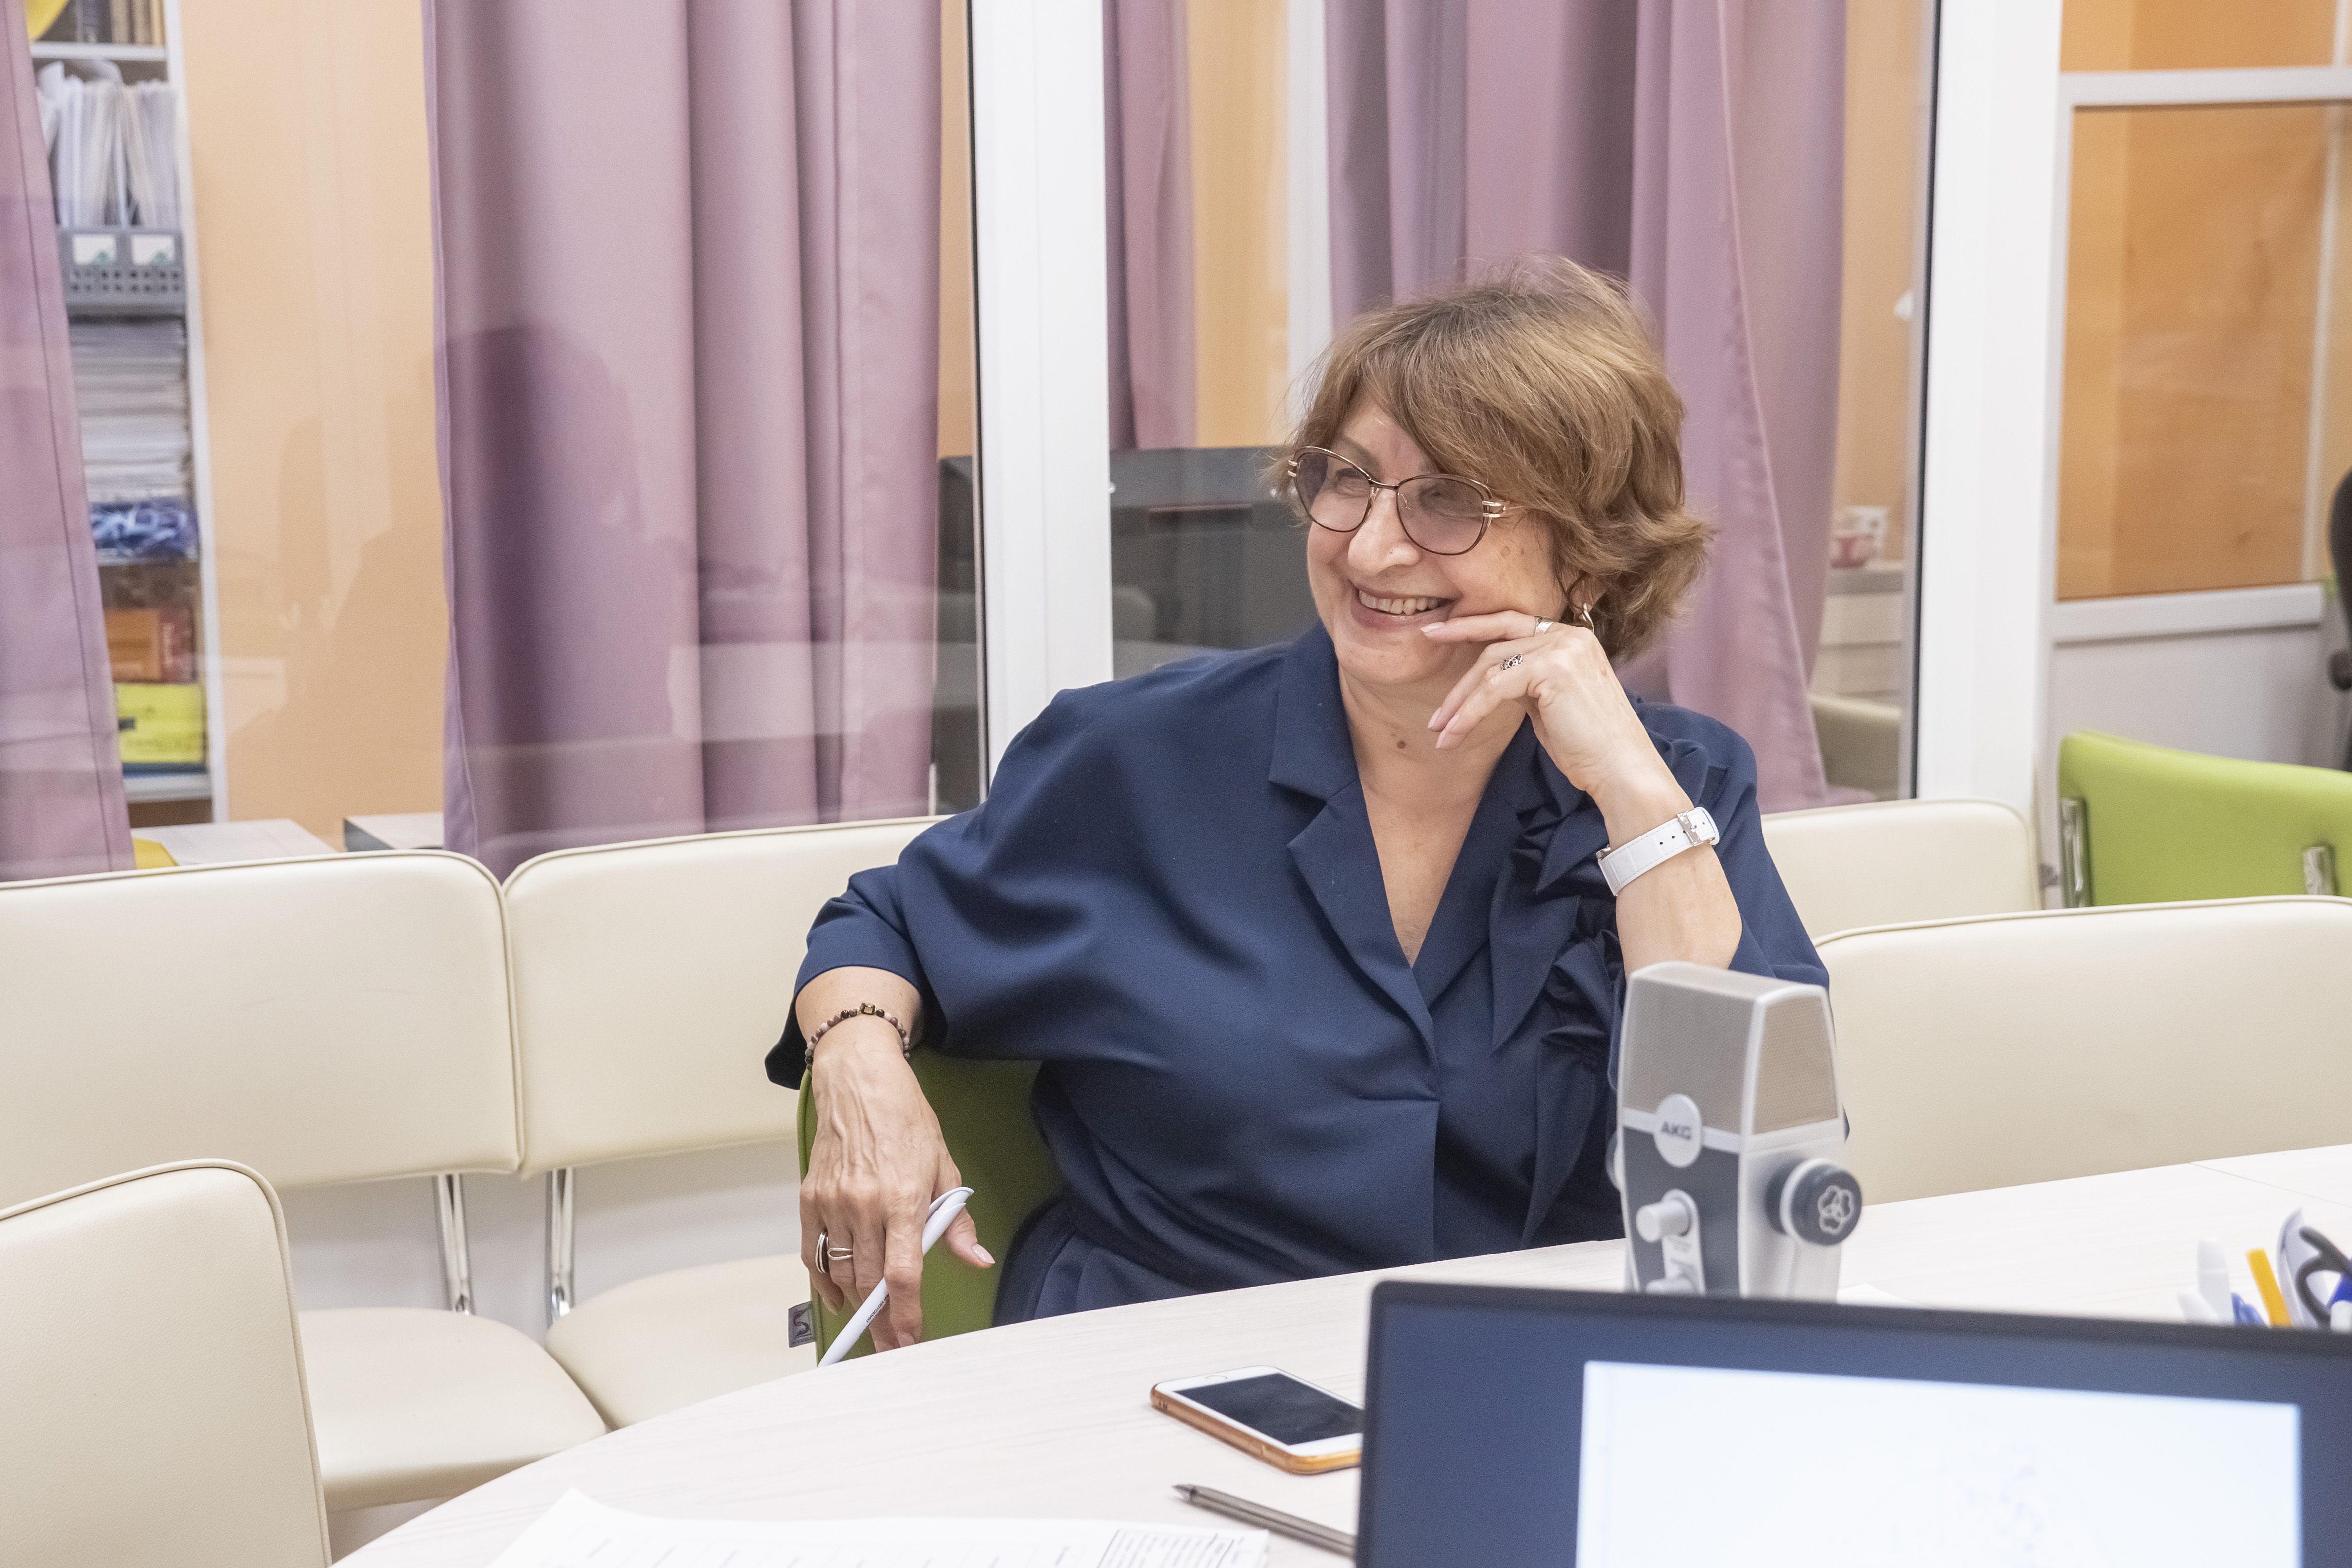
Зоя Резанова, доктор филологических наук, профессор кафедры общей, компьютерной и когнитивной лингвистики, заместитель заведующего лабораторией лингвистической антропологии ТГУ. Источник: Зоя Резанова
Следующим этапом стала экспериментальная психолингвистика: мы начали исследовать уже не только тексты, но и сами процессы восприятия и обработки языка. Затем появились билингвизм, большие корпуса данных, компьютерные методы, NLP*.
Сегодня компьютерная и когнитивная лингвистика для нас — взаимодополняющие направления. Компьютерная показывает, что многое в языке можно формализовать и исследовать автоматически. Когнитивная напоминает, что человеческие механизмы понимания гораздо сложнее любой компьютерной модели. И именно в этом зазоре возникает множество интересных научных вопросов.
* NLP (Natural Language Processing) — обработка естественного языка, направление на стыке лингвистики и компьютерных наук, которое разрабатывает методы автоматического анализа и обработки текстов и речи.
// Один из таких вопросов лежит в основе вашего проекта РНФ. Что именно вы пытаетесь понять?
Главный вопрос — как человек понимает и использует слова. Современная когнитивная наука исходит из того, что значение слова связано не только с языком как системой знаков. Огромную роль играет наш первичный перцептивный, то есть чувственный, опыт. Возьмем слово «горячий». Можно много раз его произнести, но человек не сможет в полной мере понять его значение, пока не соединит слово с собственным ощущением горячего. Этот опыт становится частью значения.
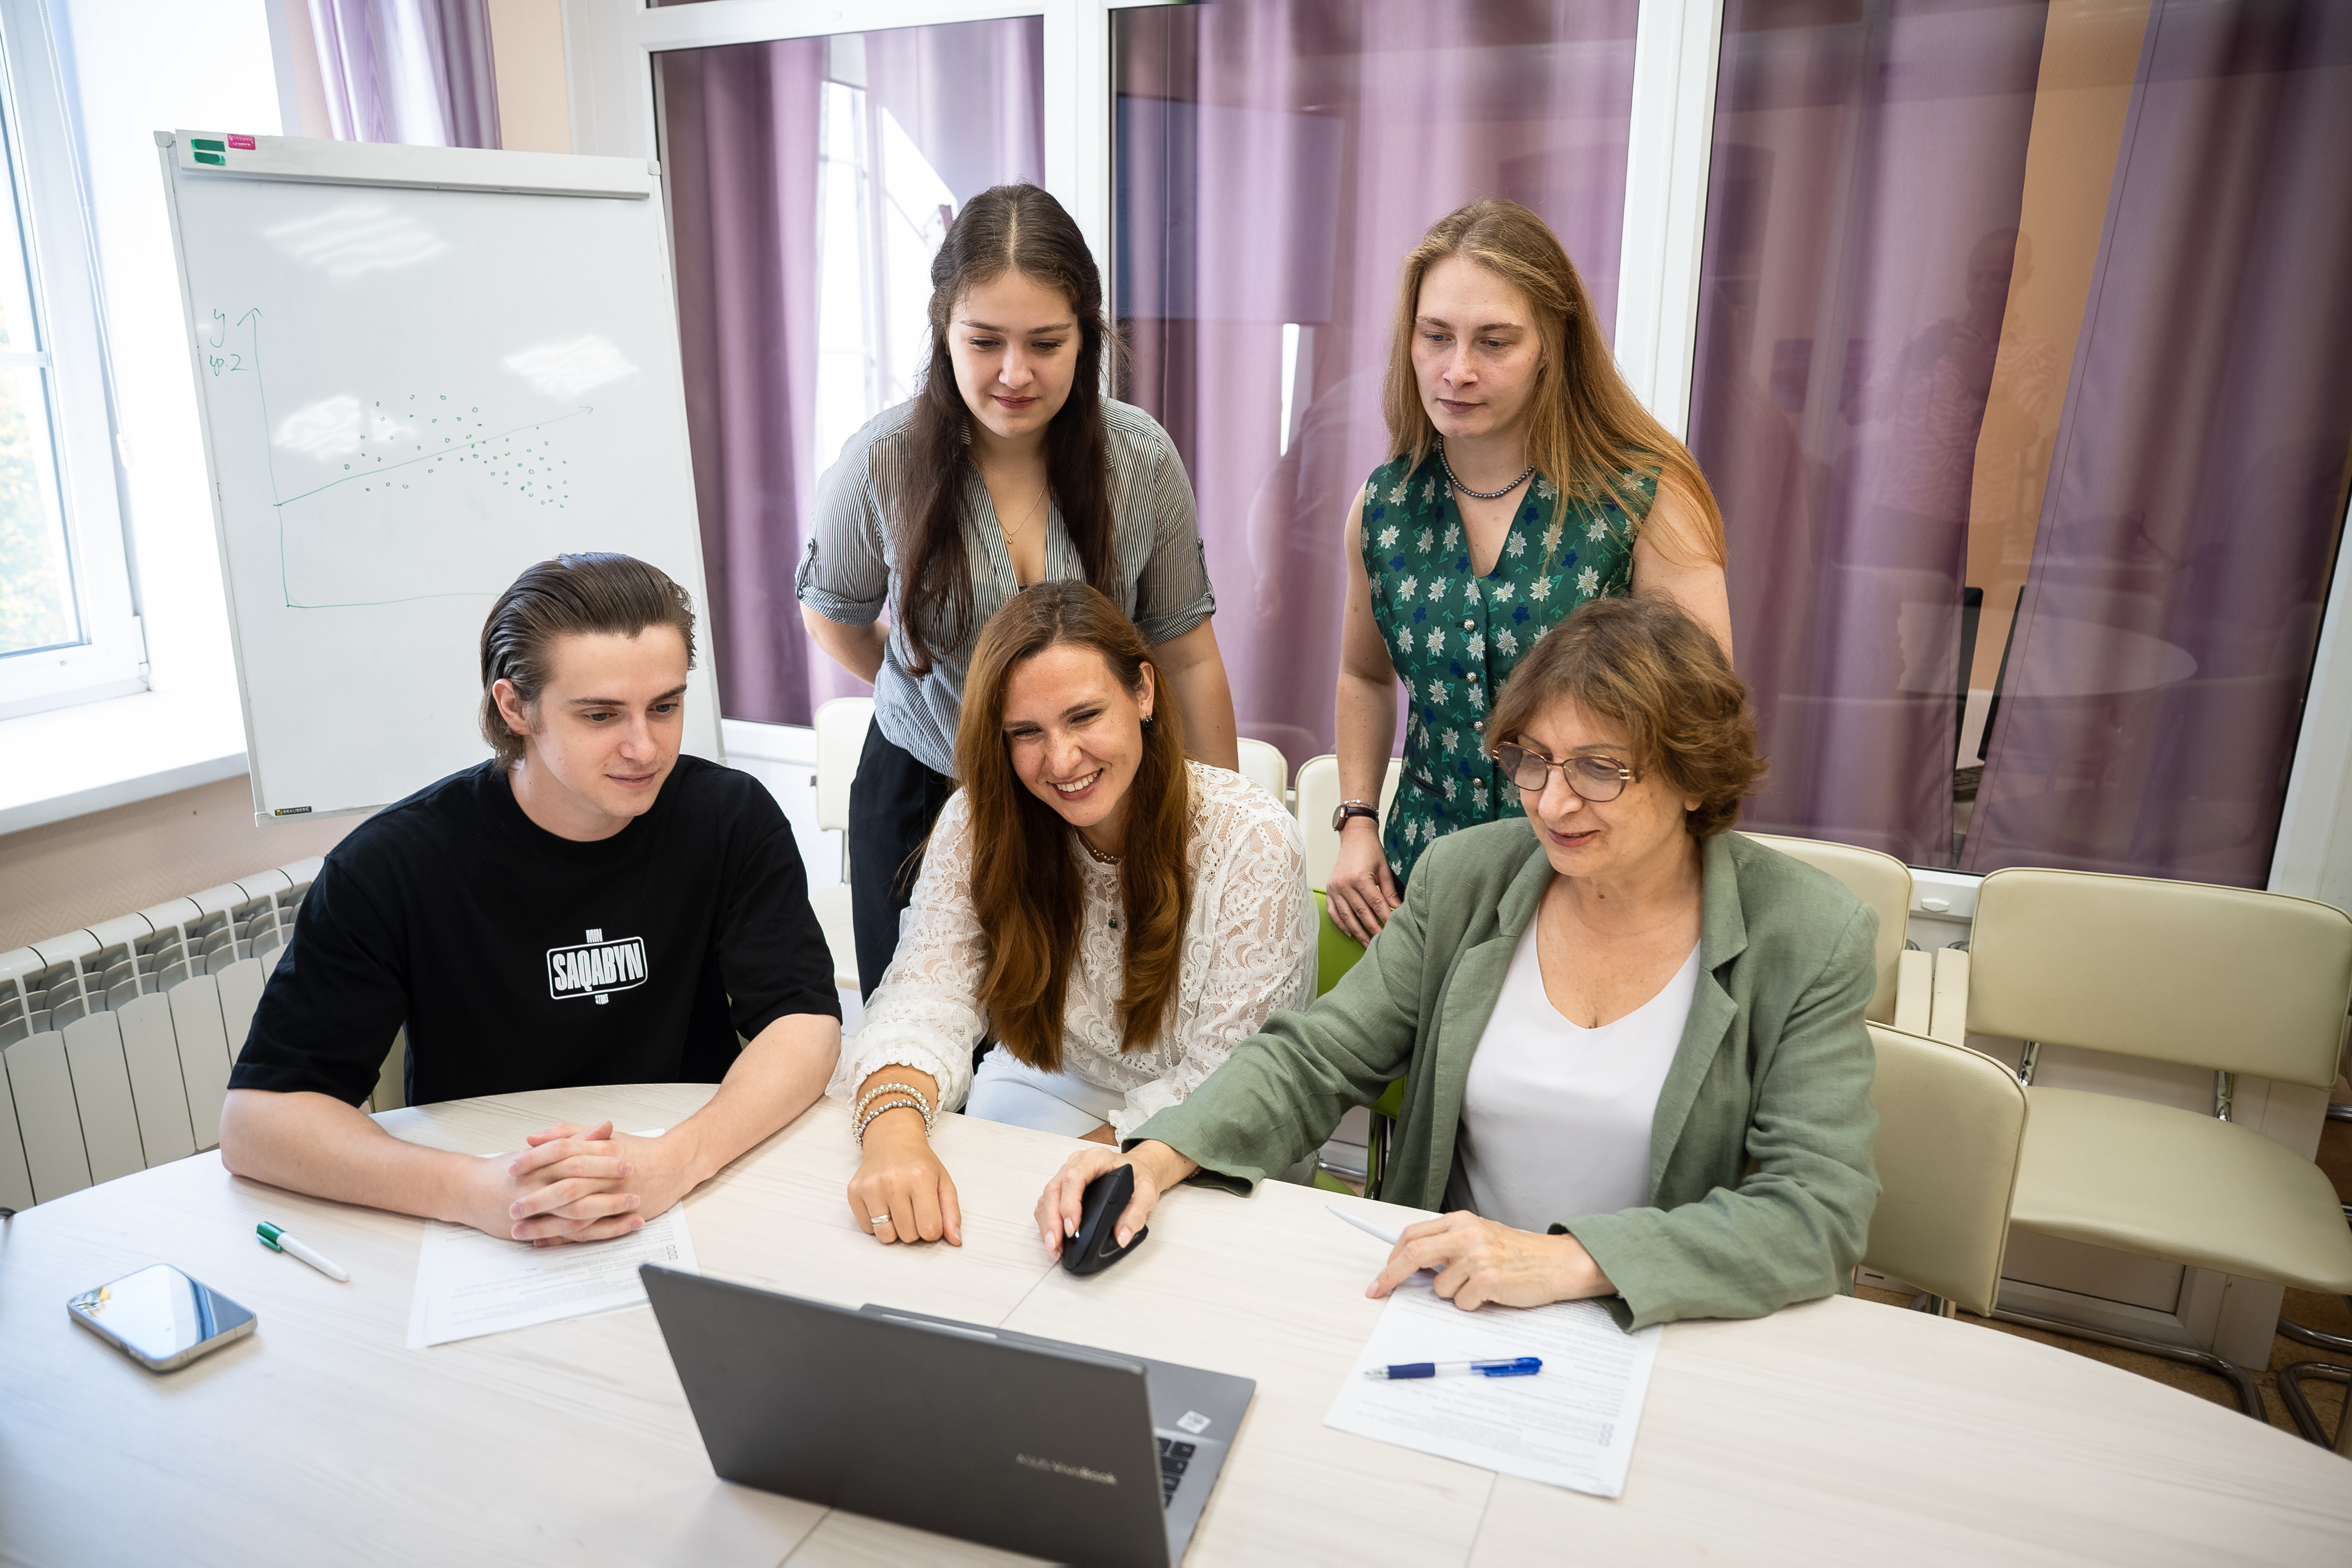
Рабочее совещание. Слева направо: стоят — Ирина Коршунова, к. ф. н. Валерия Владимирова; сидят —аспирант Федор Шамигов, аспирант Ксения Иванкова, д. ф. н. Зоя Резанова
Но есть совсем другие слова. Например, как мы понимаем слово «пошлость»? Здесь гораздо труднее найти непосредственное зрительное, вкусовое или тактильное ощущение. Его значение мы в значительной степени осваиваем через язык: встречаем слово в разных текстах и ситуациях, наблюдаем, с какими понятиями и оценками оно соседствует, и постепенно формируем представление о его смысле.
Поэтому наша исходная гипотеза состоит в том, что при понимании слова взаимодействуют два источника информации — непосредственный чувственный опыт и опыт языковой. Причем их вклад не одинаков: он зависит от самого слова, ситуации его употребления и опыта конкретного человека. Наша задача — понять, можно ли это соотношение измерить и смоделировать.
// Почему для такого исследования особенно интересен билингвизм?
Большинство классических моделей обработки языка создавались на материале так называемого прототипического носителя — человека, для которого один язык родной и основной. Но реальный языковой мир гораздо сложнее: по оценкам исследователей, более половины населения мира планеты использует два или более языка в повседневной жизни. Причем важен не только сам факт владения двумя языками, но и языковая биография человека: когда он освоил каждый язык, где им пользуется, какой из них доминирует.
Мы сравниваем два варианта. Первый — ранний естественный билингвизм. Например, ребенок растет в хакасской семье, а затем идет в школу, где основным языком становится русский. Со временем язык семьи может использоваться преимущественно дома — его называют наследственным, или херитажным. Второй вариант — учебный билингвизм, когда другой язык человек осваивает позже, прежде всего через обучение.
Отсюда наша гипотеза: язык, который входит в жизнь с рождения, непосредственно связывается со зрительным, слуховым, тактильным и другим сенсорным опытом. Язык, освоенный в учебной аудитории, в большей степени приходит через слова, тексты и объяснения. Различие этих путей отражается в том, как человек воспринимает слова.
// У вашей команды уже есть большой опыт исследования тюркско-русского билингвизма. Что дал этот этап работы?
Важным для нас стал проект по исследованию языкового разнообразия Южной Сибири. Мы работали с шорско-русским, хакасско-русским и татарско-русским билингвизмом. В результате был создан RuTuBiC — корпус русской речи тюркско-русских билингвов объемом более 500 часов звучания. Для его создания члены нашей лаборатории ездили в экспедиции, записывали речь носителей нужного типа билингвизма, затем расшифровывали и размечали материал.
Такой корпус позволяет увидеть реальную устную речь во всем ее многообразии — анализировать лексику, морфологию, синтаксис, произношение, сопоставлять разные группы и проверять наблюдения количественно. При этом подобные материалы имеют ценность не только для лингвистики. Когда пожилые носители шорского или другого языка рассказывают о своей семье, детстве, традициях, истории поселения, мы сохраняем свидетельства культурной памяти. Поэтому один и тот же корпус может становиться источником для разных гуманитарных исследований.
// В проекте большое внимание уделяется перцептивному, или чувственному, опыту. Как вообще можно измерить, насколько слово связано со зрением, вкусом или осязанием?
Мы рассматриваем пять базовых модальностей восприятия: зрение, слух, осязание, обоняние и вкус. Для русского языка наша лаборатория создавала специальные психолингвистические базы данных. Участнику эксперимента предлагают слово и просят по семибалльной шкале оценить, насколько его значение связано с каждой из пяти модальностей. Так формируется своеобразный перцептивный профиль слова.
Допустим, некоторые слова имеют очевидную зрительную составляющую, другие теснее связаны со слухом, вкусом или запахом. В мировой психолингвистике показано, что зрительная модальность в целом доминирует и часто взаимодействует с осязательной. Слуховая занимает несколько более обособленное положение, а слов, сильно связанных прежде всего со вкусом и обонянием, значительно меньше.
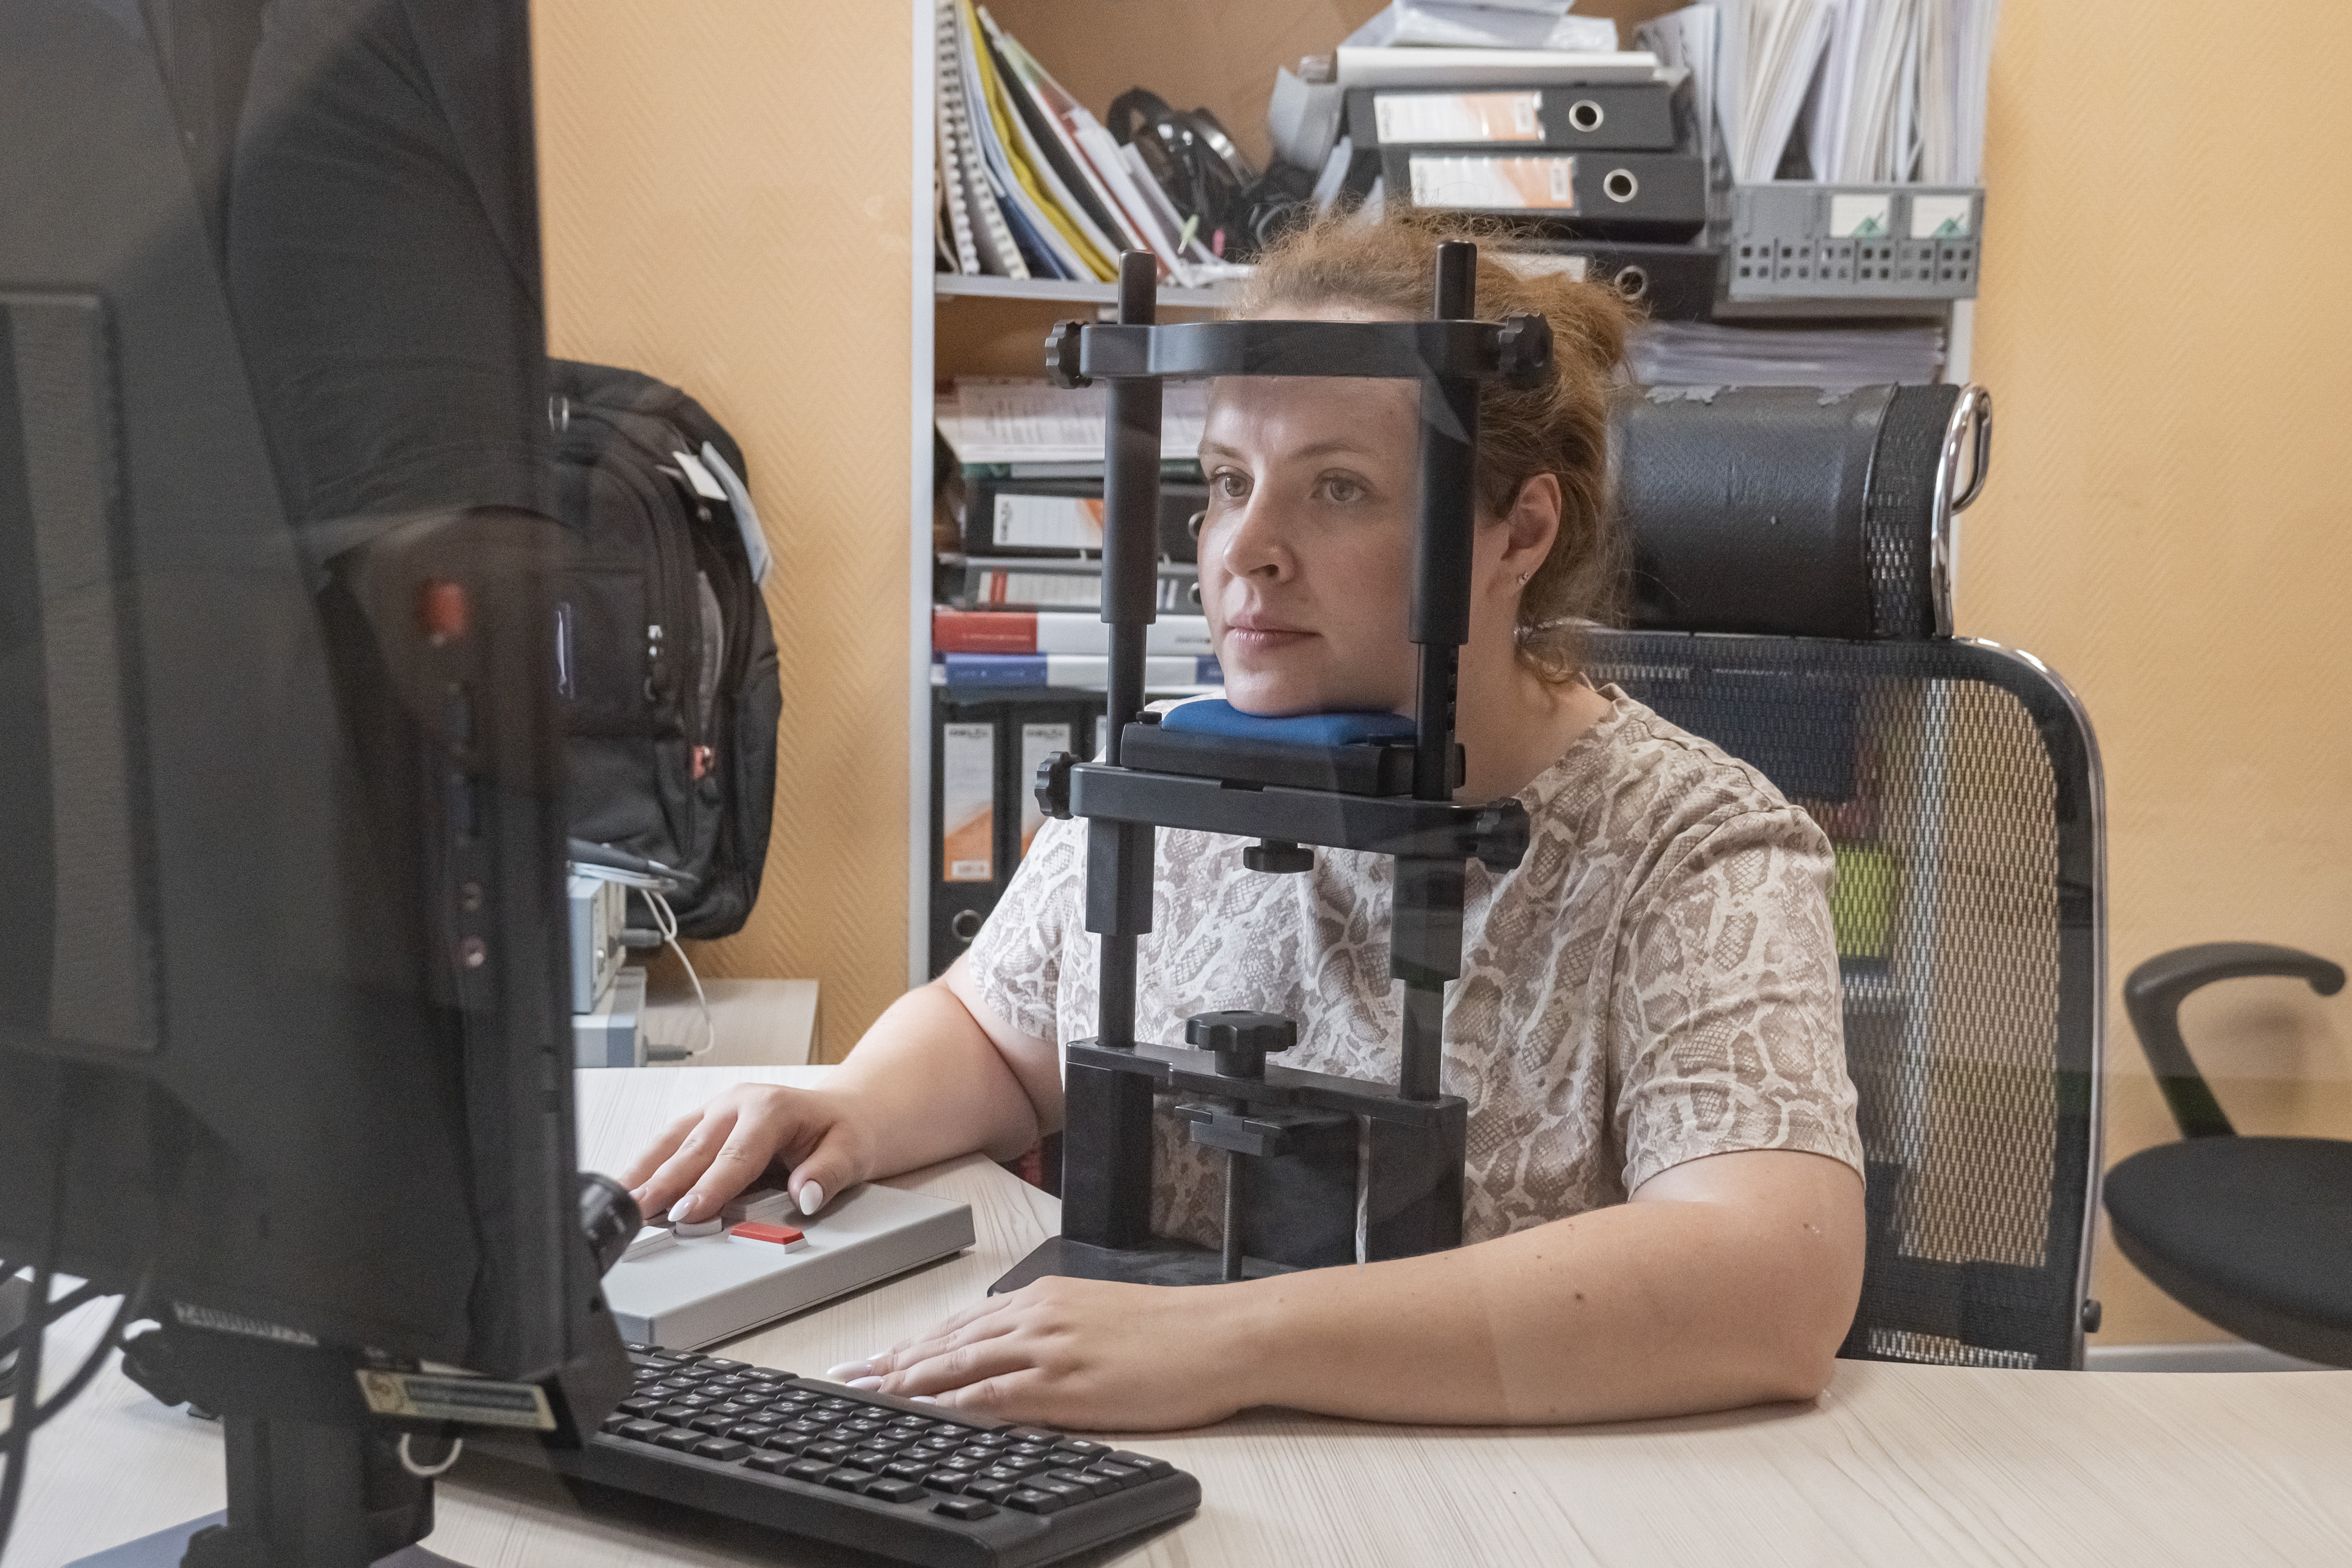
Участница исследования во время прохождения эксперимента с регистрацией движений глаз. Источник: Зоя Резанова
Но для нас важна не сама классификация слов. Получив такие оценки, мы можем исследовать, влияет ли их перцептивный профиль на когнитивную обработку: например, насколько быстро человек распознает слово, принимает решение о его значении, относит его к определенной категории. И здесь начинается экспериментальная часть работы.
// Вы не раз говорили, что сегодня гуманитарию уже недостаточно «оставаться наедине с текстом». Почему?
Я абсолютно уверена, что нет ни одного метода, который был бы панацеей. Работа с текстом, филологическое и лингвистическое наблюдение никуда не исчезают: часто именно с них начинается формулировка гипотезы. Но возможности человека ограничены. Сколько книг я могу внимательно прочитать, чтобы проверить, в каких контекстах встречается слово — десять, тридцать, пятьдесят?Компьютерные методы увеличивают материал на порядки и дополняют качественный анализ количественной доказательной базой.
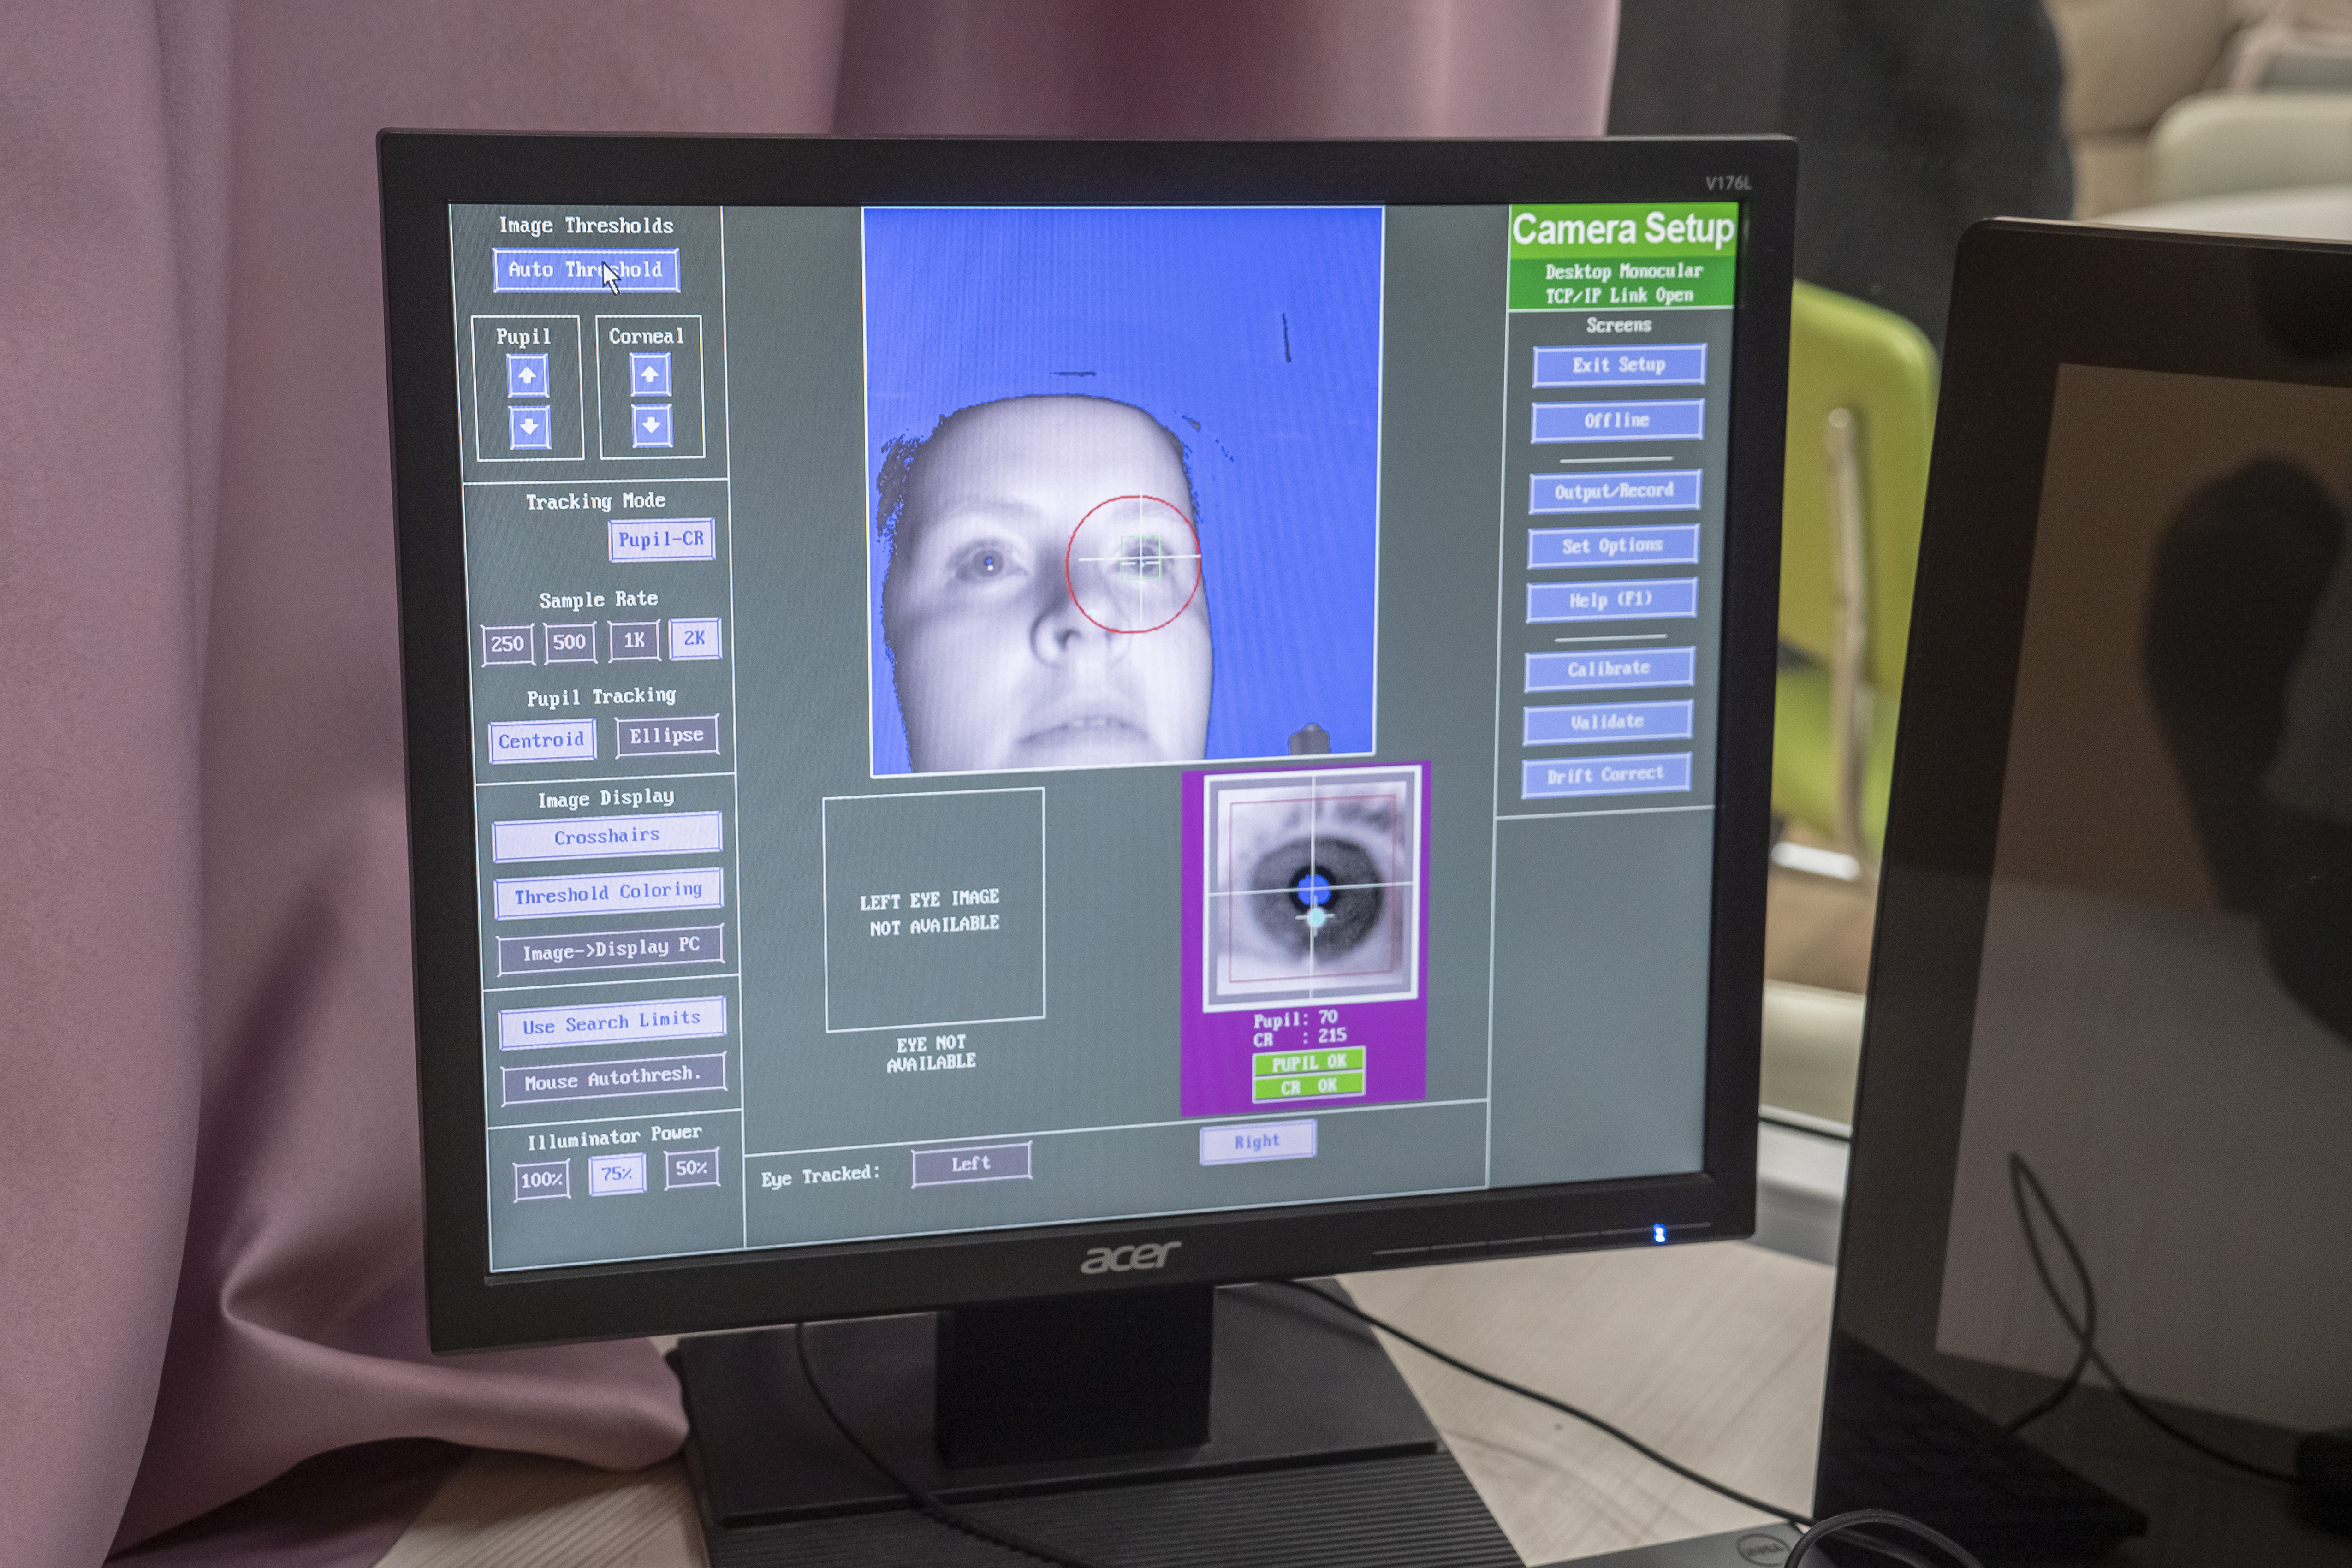
Калибровка и регистрация положения глаз участника эксперимента. Источник: Зоя Резанова
То же самое происходит в эксперименте. Мы работаем с сотнями слов и измеряем реакции участников с точностью до миллисекунд. В других исследованиях используем окулографию — айтрекинг, который позволяет проследить движение глаз во время чтения. В результате получаем огромные массивы данных, а статистические методы помогают увидеть закономерности, которые на нескольких десятках примеров просто не обнаружить.
// Получается, меняется и сам профессиональный профиль лингвиста?
Конечно. Именно поэтому несколько лет назад мы стали развивать в Томском университете компьютерную лингвистику как самостоятельное образовательное направление, а затем объединили ее с когнитивной. Современный компьютерный лингвист действует на стыке двух областей. Он должен понимать устройство естественного языка, уметь анализировать его структуру и значения, но одновременно владеть статистикой, программированием, методами обработки текстовых данных, машинного обучения.
В команду могут приходить люди с разных сторон. Лингвисту необходимо осваивать программирование, чтобы проверять свои гипотезы на больших массивах материала. Специалисту с математической или IT-подготовкой, наоборот, требуется глубокое понимание того, насколько сложен естественный язык и почему его далеко не всегда можно просто «разложить по полочкам» для компьютера.
Сегодня молодые исследователи в нашей команде программируют, работают со статистическими пакетами, создают и размечают корпуса, проводят эксперименты, строят компьютерные модели. Но при этом для меня принципиальна одна вещь: исследователь должен не только уметь запустить алгоритм, но и понимать, какой научный вопрос он с его помощью задает и что именно означают полученные числа.
// В нынешнем проекте вы как раз соединяете психолингвистический эксперимент с компьютерными моделями значения слов. Как это работает?
Объясню на примере слова «кислый». Человек знает, что оно означает, в том числе благодаря собственному вкусовому опыту. Но компьютерная модель никогда ничего кислого не пробовала. Откуда она может получить информацию о значении этого слова? Из языка — прежде всего из контекстов, в которых слово употребляется. Здесь действует один из базовых принципов дистрибутивной семантики: слова с близкими значениями часто встречаются в сходном окружении.
Можно привести простой пример. Я говорю: «Хозяйка жарит хворост на плите». У слова «хворост» есть разные значения: ветки и разновидность печенья. Но человек сразу понимает, что в этом предложении речь идет о еде. Почему? Благодаря другим словам — «хозяйка», «жарит», «на плите» — и накопленному языковому и жизненному опыту.

Проведение психолингвистического эксперимента: участники знакомятся с инструкцией. Источник: Зоя Резанова
Отсюда один из центральных вопросов проекта: если человеческий чувственный опыт оставляет след в языке, можем ли мы обнаружить его в текстах с помощью компьютерной модели? Для этого мы сопоставляем два совершенно разных источника данных. С одной стороны — экспериментальные оценки людей, показывающие, насколько значение слова связано с разными сенсорными модальностями. С другой — семантические расстояния между словами, которые дает компьютерная модель. Это и есть пример того междисциплинарного синтеза, который для нас особенно важен.
// Какие результаты первого года проекта стали показательными?
На первом этапе мы построили три модели перцептивного опыта: для носителей русского языка как родного, херитажных и учебных билингвов. Проще говоря, сравнили, насколько значение одних и тех же слов связано у этих групп со зрением, слухом, вкусом, запахом и осязанием. Оказалось, что эта «чувственная карта» слова зависит от языкового опыта: отдельные модальности могут играть разную роль и по-разному сочетаться между собой.
Для нас это важный результат, который показывает, что билингвов нельзя рассматривать как однородную группу. Имеет значение, когда и в каких условиях человек освоил каждый язык и как пользуется им сегодня.
Параллельно мы моделировали языковой опыт. На корпусе русских текстов TAIGA построили пять моделей значений слов — Word2vec, FastText, GloVe, RuBERT и XLM-RoBERTa. И получили интересный результат: в нашей конкретной задаче лучше всего сработала сравнительно простая статическая модель GloVe.
// Почему более простая модель оказалась эффективнее более сложных контекстуальных?
Потому что нельзя говорить, что какая-то модель лучше других. Все определяется исследовательской задачей. Наши экспериментальные данные во многих случаях получены при предъявлении отдельного слова, вне предложения. Статическая модель тоже дает слову относительно устойчивое представление. Контекстуальные RuBERT и XLM-RoBERTa учитывают, что значение меняется в зависимости от окружения. Для многих задач это — преимущество, но в нашем эксперименте оно не обязательно дает лучший результат.
Для меня здесь важен более общий урок. Сегодня велик интерес к искусственному интеллекту и большим моделям, и иногда кажется, что нужно обязательно использовать самый новый и мощный инструмент. Мы активно используем ИИ в исследованиях, но понимаем его ограничения. Уверена, метод должен определяться научным вопросом, а не технологической модой. Если задачу надежнее решает более простая модель, значит, она и нужна.
// Чем обусловлен выбор языков для исследований?
Многие базовые модели психолингвистики и когнитивной науки первоначально создавались прежде всего на материале английского, а затем других крупных европейских языков. Поэтому сначала нам было важно проверить выявленные закономерности на русском.
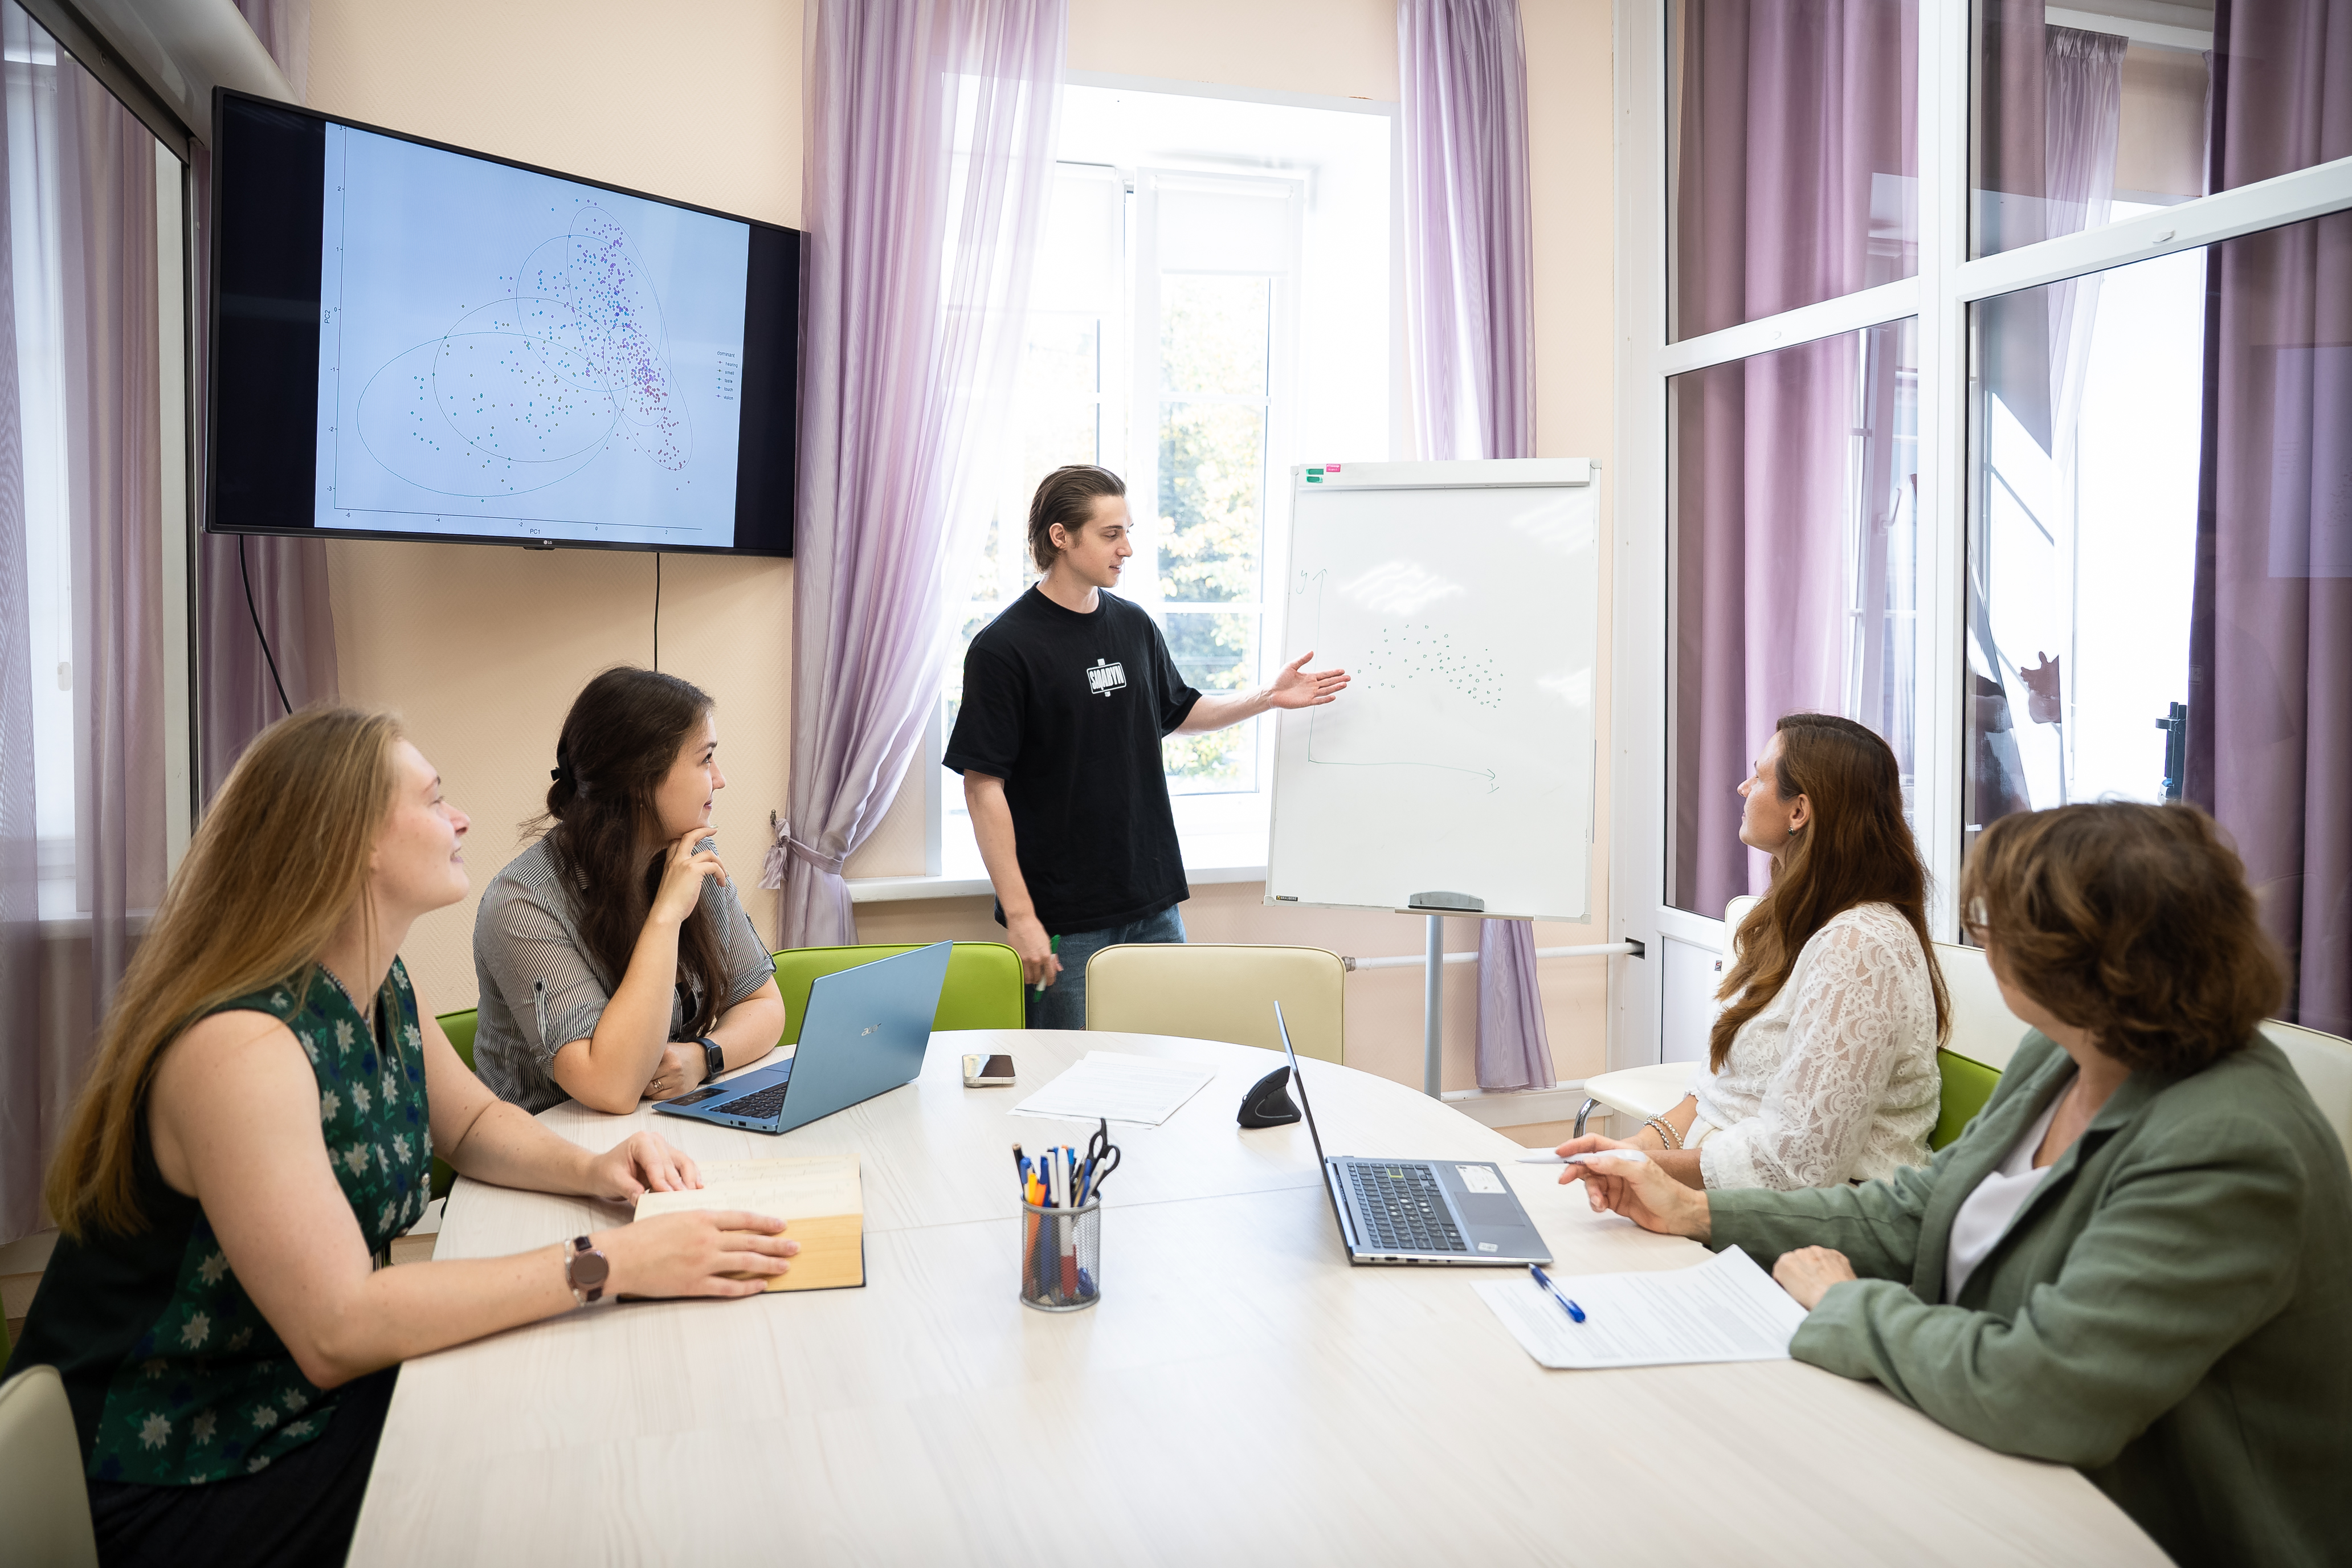
Обсуждение результатов векторизации текстов с использованием трех LLM. Слева направо: к. ф. н. Валерия Владимирова, Ирина Коршунова, аспирант Федор Шамигов, аспирант Ксения Иванкова, д. ф. н. Зоя Резанова. Источник: Зоя Резанова
Следующий шаг — языки народов России, значительно хуже представленные в международных психолингвистических базах. Без языкового разнообразия трудно понять, какие закономерности универсальны, а какие связаны со структурой конкретного языка или языковой биографией человека. Здесь есть и важная гуманитарная составляющая: вводя данные малоресурсных языков в современную экспериментальную и компьютерную лингвистику, мы делаем их частью актуального мирового научного пространства.
// Какой главный научный вопрос вы рассчитываете решить благодаря проекту?
Если свести задачу к самой сути, мы пытаемся объединить две исследовательские традиции. Одна связывала понимание языка прежде всего с телесным и чувственным опытом, другая подчеркивала роль самого языка и контекстов, в которых мы встречаем слова. Наша гипотеза состоит в том, что в понимании значения участвуют оба типа опыта, но их вклад меняется в зависимости от слова и языковой биографии человека: является ли этот язык для него первым или вторым, когда и как он был освоен.

В итоге мы хотим построить интегративную модель этого взаимодействия. Новизна здесь не столько в самой идее, сколько в доказательной базе: мы объединяем психолингвистический эксперимент, корпуса текстов, компьютерные модели и статистический анализ. Мне кажется, это очень характерно для современной гуманитарной науки: большие вопросы о языке, мышлении и человеке остаются прежними, но способы искать ответы на них становятся совершенно другими.
// Как поддержка Российского научного фонда помогает реализовывать междисциплинарные исследования?
Такой проект невозможно выполнить силами одного специалиста: здесь нужны лингвисты, психолингвисты, специалисты по билингвизму, корпусным и компьютерным методам, программированию и статистике.
Я уже давно не ставлю перед собой задачу быть специалистом во всех этих областях — сегодня это невозможно. Задача руководителя — видеть общую логику исследования и собрать людей, чьи компетенции дополняют друг друга. Поэтому особенно важна возможность сформировать устойчивую команду и планировать работу на несколько лет вперед.
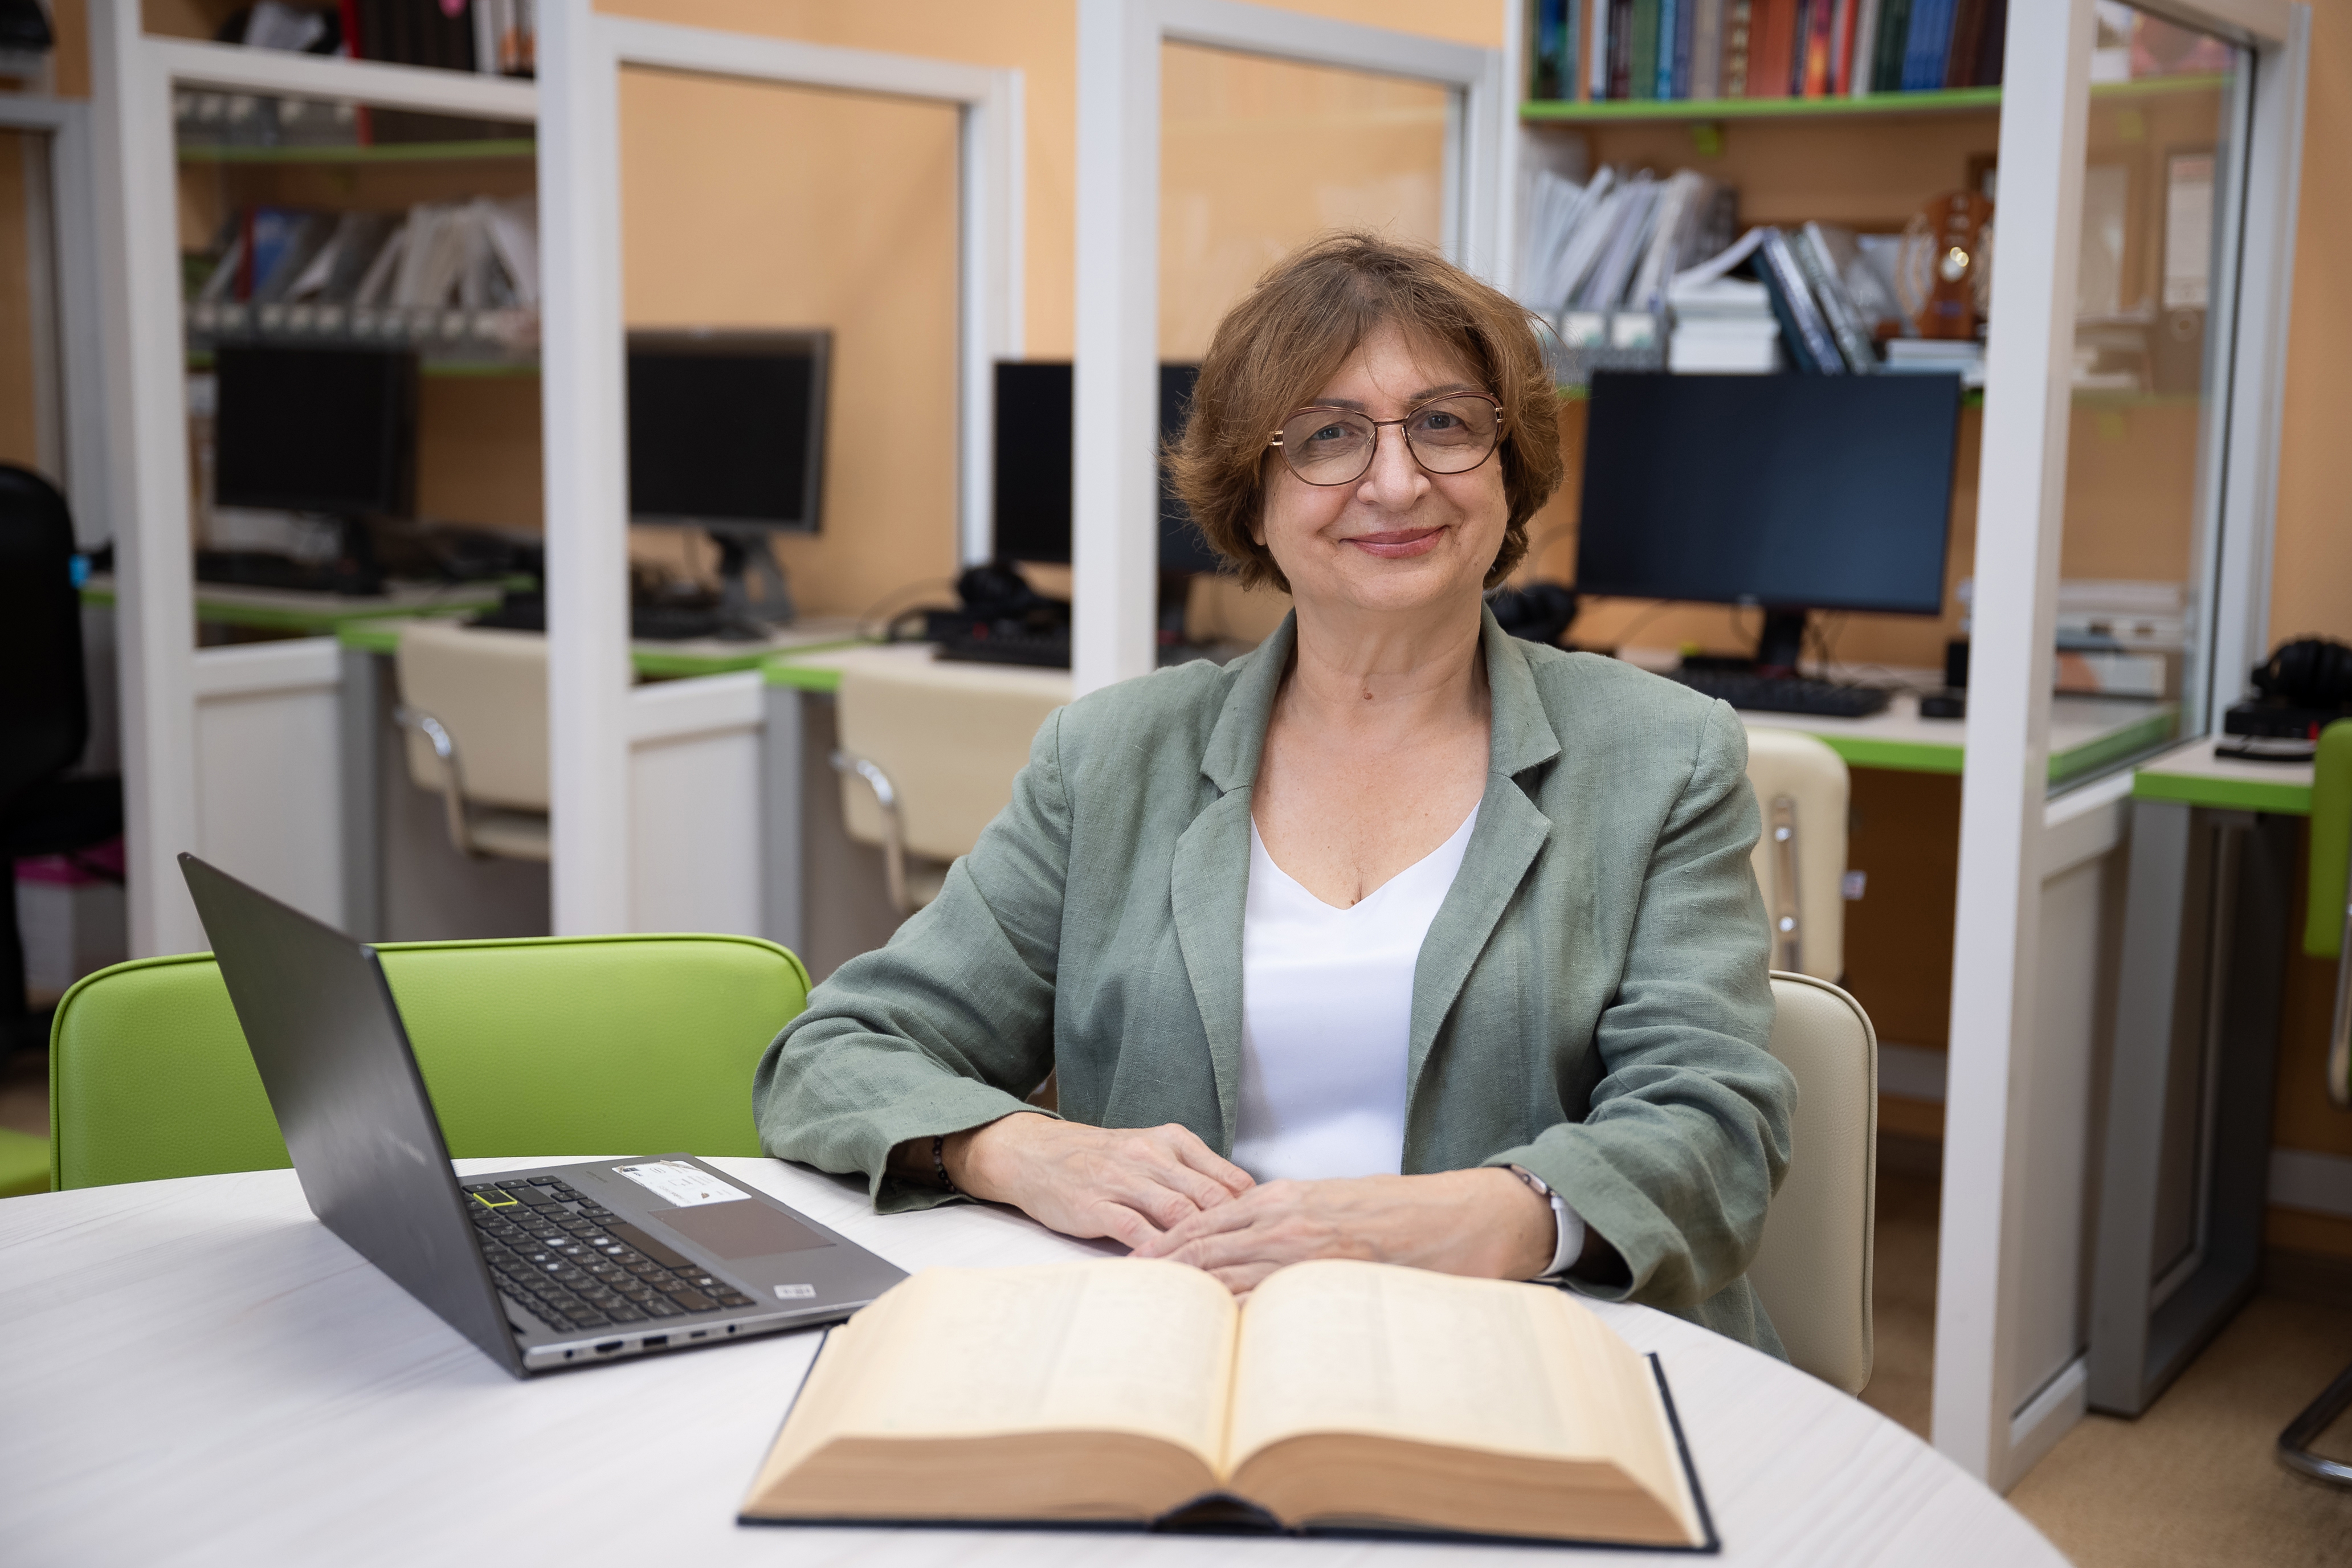
Источник: Зоя Резанова
Наши эксперименты требуют долгой подготовки. Исследования, запланированные на третий год проекта, мы готовим уже сейчас: отбираем материал, формируем группы участников, разрабатываем процедуры и программы обработки данных. Поддержка РНФ позволяет сосредоточиться на этой работе. И для меня особенно важно, что Фонд поддерживает междисциплинарные исследования в гуманитарных и социальных науках. Сегодня гуманитарий может соединять тонкое чтение текста, эксперимент и компьютерную модель. Это не отменяет традиционную филологию, а расширяет ее возможности.
Оставаться наедине с текстом сегодня уже недостаточно. Но увидеть за огромным массивом данных язык и человека по-прежнему остается главной задачей исследователя.